Первое действие
Послушай короткую запись ниже. Выпиши важные числа и условия, затем сравни их с расшифровкой. Непонятное место переслушай.
Ниже — подробный разбор, примеры и объяснения. Если встретишь незнакомое слово, открой короткий словарь.
Клиент прислал голосовое: что сделать, к какому дню, сколько готов потратить. Ты прослушал его, отвлёкся и помнишь только часть. Потом выясняется: сумму он исправил в середине сообщения, срок относился к первому экрану, а готовый сайт к этой дате никто не обещал.
Расшифровка помогает получить слова из записи. Но слова ещё нужно проверить и правильно понять. Покажем оба действия на коротком примере в нашей разработке «Штаб»: загрузим аудиофайл, посмотрим настоящий результат и отделим договорённости от того, что ещё предстоит уточнить.
Наш пример: два числа и одно исправление
Представь: ты готовишь страницу вебинара. В сообщении клиент упоминает 15 тысяч рублей, затем поправляется — 50 тысяч. Причём это верхняя граница бюджета, а не утверждённая стоимость работ.
Для проверки мы сделали учебную запись с синтетическим голосом. Это не переписка настоящего клиента. Запись длится около 41 секунды; её действительно загрузили в отдельную копию «Штаба» и получили ответ сервиса распознавания. Текст результата не подменяли.
Послушай исходник. Обрати внимание на исправление суммы и слова «не обещаем», «ещё не прислали», «не договорились».
Анна, по странице вебинара нужно подготовить первый экран и блок с программой. Пришли ссылку двадцать первого сентября к пятнадцати часам. Весь сайт к этому сроку мы не обещаем. По бюджету можно ориентироваться на пятнадцать… Нет, я оговорился: на пятьдесят тысяч рублей. Это верхняя граница, а не согласованная цена. Фотографии спикеров ещё не прислали. Бота пока не запускаем. Когда будет готова вся страница, мы пока не договорились.
У этого сообщения есть несколько смысловых ловушек. Если просто попросить «кратко перескажи», можно получить уверенное: «Сделать сайт за 50 тысяч к 21 сентября». Это пример неверного вывода, а не ответ, который нам вернула система. В записи согласовано гораздо меньше.
Что понадобится до начала
- Аудиофайл, который ты вправе использовать для этой задачи. Для первого прохода подойдёт наша учебная запись.
- Доступ к инструменту распознавания аудио. На скриншотах показан «Штаб»; его подключение зависит от выбранного формата работы с Лабораторией.
- Возможность прослушать исходник ещё раз: наушники или обычный проигрыватель.
- Место для короткой записи результата: документ, таблица или карточка клиента.
Если доступа к «Штабу» нет, скачай готовую расшифровку ниже и повтори смысловую проверку. Её можно выполнить вручную или с помощником, которым ты уже пользуешься. Если твой сервис принимает аудиофайлы, начни с той же учебной записи и сравни результат по нашей таблице. Названия кнопок в других сервисах отличаются.
Распознавание может оплачиваться отдельно или расходовать лимит подключённого сервиса. Уточни условия до загрузки длинного интервью. Наш короткий тест не устанавливает цену твоего рабочего процесса.
Не загружай без необходимости записи с чужими телефонами, медицинскими сведениями, паролями и другими чувствительными данными. Для освоения достаточно учебного файла.
Шаг 1. Подготовить именно нужную запись
Сохрани исходное аудио в отдельную папку. Дай файлу понятное имя: например, «Вебинар — вводные клиента — 18 сентября». Не заменяй оригинал исправленной версией: к нему нужно будет вернуться при спорном числе или слове.
Открой файл в проигрывателе и прослушай начало. Убедись, что это нужное сообщение, звук слышен и запись не оборвалась. Если клиент прислал несколько сообщений, сохрани их порядок. Позднее сообщение может отменять условия из раннего.
В нашем примере всего один файл. Обработку нескольких говорящих одновременно, шумной записи и длинного интервью этим тестом не проверяли.
Ожидаемый результат: у тебя есть воспроизводимый аудиофайл и понятно, к какой задаче он относится.
Шаг 2. Получить текст в «Штабе»
В интерфейсе из разбора открой раздел «Задачи», затем нажми «Голосом». Появится окно «Задачи голосом».
- Нажми «Файл созвона» рядом с кнопкой записи голоса.
- Выбери сохранённый аудиофайл. Мы загрузили WAV-файл из этой статьи.
- Дождись окончания распознавания. Во время обработки кнопка показывает «Распознаю…».
- Прочитай текст, который появился в большом поле.
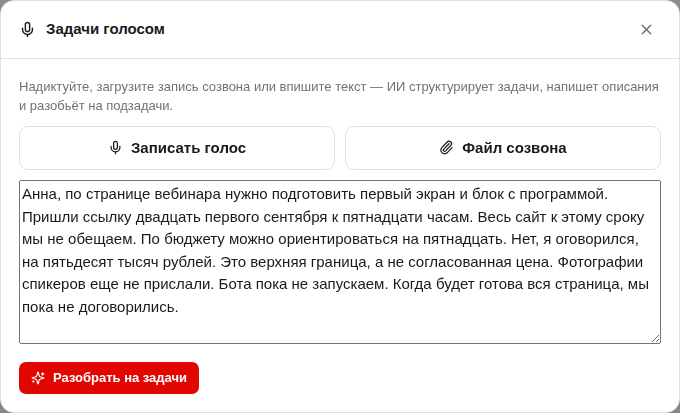
Скриншот настоящего интерфейса после загрузки записи. Распознавание сохранило оговорку и её исправление. Данные учебные; речь озвучена синтетическим голосом.
В этой проверке слова совпали по смыслу с исходником. Система расставила знаки препинания по-своему: пауза после слова «пятнадцать» превратилась в точку. Это не изменило договорённость, потому что фраза с исправлением сохранилась рядом.
Пока не нажимай «Разобрать на задачи». Сначала проверим расшифровку. Создание поручений — следующий этап, и его отдельно разбираем в статье о протоколах встреч.
Шаг 3. Проверить шесть важных деталей
Не обязательно править каждую запятую. Сначала проверь сведения, ошибка в которых меняет работу или деньги.
| Что проверяем | Что есть в записи и расшифровке | Как фиксируем |
|---|---|---|
| Кому обращаются | Анна | Адресат — Анна; это ещё не подтверждение, что она приняла поручение |
| Что нужно сделать | Первый экран и блок программы | Не весь сайт |
| Что и когда показать | Ссылку 21 сентября к 15:00 | Год не назван; в реальной работе его нужно определить из контекста или уточнить |
| Что сказано о деньгах | Сначала 15, затем исправление на 50 тысяч рублей | Предел бюджета — 50 тысяч; цена не согласована |
| Чего не хватает | Фотографии спикеров ещё не прислали | Материалы ожидаются; кто и когда пришлёт — не названо |
| Что пока не делаем | Бота не запускаем; дата готовности всей страницы не согласована | Не добавляем запуск бота и сдачу всей страницы в обязательства |
В нашем проходе эти шесть пунктов сохранились в распознанном тексте. Это результат одной короткой записи с ровной синтетической речью, а не процент точности сервиса на живых клиентах.
На своей записи прослушай участки с суммой, датой, фамилией и отрицанием. Особенно легко потерять короткое «не»: «согласовали» и «не согласовали» дают противоположный результат.
Если слово не разобрать, запиши «нужно уточнить». Не выбирай наиболее правдоподобную сумму. Понятная пометка о неизвестном полезнее красивого, но выдуманного ответа.
Шаг 4. Отделить текст от договорённостей
Сохрани исходную расшифровку отдельно. Рядом сделай короткую рабочую карточку. Так ты не потеряешь, что действительно прозвучало, когда начнёшь сокращать и переформулировать.
Вот как выглядит проверенная карточка для нашего сообщения:
Задача: подготовить первый экран страницы вебинара и блок программы.
Показать: ссылку 21 сентября к 15:00. Год в записи не назван.
Адресат: Анна. Принятие поручения в этой записи не подтверждено.
Деньги: 50 000 рублей — верхняя граница бюджета, не согласованная цена.
Ожидаем: фотографии спикеров; отправитель и срок не указаны.
Не входит в эту договорённость: запуск бота и готовность всей страницы к 21 сентября.
Уточнить: год, итоговую стоимость, дату получения фотографий и срок готовности всей страницы.
Эта карточка подготовлена отдельно от распознавания и сверена с исходным текстом записи. Это пример оформления договорённостей, а не автоматический ответ сервиса.
Если хочешь поручить первый черновик ИИ, скопируй задание ниже и добавь свой проверенный текст. Ответ всё равно сверяй с записью.
Этот блок написан для нейросети. Вставь его в разговор, затем добавь нужные материалы. Учить текст задания не нужно.
Помоги разобрать сообщение клиента. Используй только текст, который я дам.

Сначала выпиши:
1. Что нужно сделать.
2. Какой результат и к какому сроку нужно показать.
3. Кому адресовано сообщение и подтверждено ли принятие поручения.
4. Что сказано о деньгах: согласованная цена, предел бюджета или предположение.
5. Какие материалы ещё нужны.
6. Что прямо исключено или пока не согласовано.
7. Какие вопросы нужно уточнить.

К каждому важному выводу добавь короткую цитату из исходного текста.
Если говорящий исправил число, сохрани исправление и объясни, какое число действует.
Не превращай пожелания и идеи в принятые обязательства.
Не придумывай год, часовой пояс, цену, исполнителя и отсутствующие сроки.
Если информации нет, напиши «не указано».
Не отправляй сообщения клиенту и не создавай задачи.

Мой текст сообщения:
Как вставить: сначала скопируй задание в поле своего ИИ-помощника, затем после последней строки добавь расшифровку. Если в ответе появилась информация, которой нет в исходнике, убери её и отметь вопрос для уточнения. Этот дополнительный промпт — подсказка для самостоятельной работы; он не является скрытой инструкцией распознавания в «Штабе».
Шаг 5. Уточнить неизвестное одним сообщением
После проверки не обязательно отправлять клиенту весь протокол. Достаточно коротко подтвердить важное и задать оставшиеся вопросы.
Например, черновик для проверки человеком:
Правильно понял: к 21 сентября, 15:00 показываем первый экран и блок программы. Весь сайт и запуск бота в этот срок не входят. 50 000 рублей — предел бюджета, итоговую стоимость ещё согласуем. Подтверди, пожалуйста, год и когда ждать фотографии спикеров. Срок готовности всей страницы обсудим отдельно.
Это пример текста, мы его никому не отправляли. Перед отправкой в своей работе проверь, подходит ли такой тон клиенту и действительно ли все вопросы нужны: часть ответов может уже быть в договоре или другом сообщении.
Только после подтверждения переноси условия в рабочую задачу, предложение или карточку клиента. Если клиент меняет срок или сумму, сохрани новое подтверждение рядом с прежним, чтобы было понятно, почему условия изменились.
Если запись не загружается или результат сомнительный
| Что случилось | Что проверить | Как действовать |
|---|---|---|
| Выбранный файл пустой | В нём действительно есть звук и размер больше нуля | Сохрани запись заново; пустой файл не даст расшифровку |
| Запись слишком большая | В проверяемом обработчике «Штаба» стоит ограничение 25 МБ | Возьми нужный фрагмент или раздели запись, сохранив порядок частей |
| Распознавание не завершилось | Появилось ли сообщение об ошибке, работает ли подключённый сервис | Сохрани оригинал, проверь доступ; не считай отсутствие ответа успешной обработкой |
| Имена и числа выглядят странно | Соответствующий момент в исходном звуке | Исправь вручную или уточни у говорящего |
| Текст есть, но условия противоречат друг другу | Было ли исправление, предположение или отрицание | Сохрани обе фразы и уточни итоговое условие |
| Одновременно говорят несколько человек | Можно ли понять, кто произнёс ключевую фразу | Отметь неизвестного говорящего; не назначай автора по догадке |
Мы проверили загрузку одного WAV-файла. Другие форматы, плохую связь, шумные переговоры и разговор нескольких людей в этот проход не тестировали. Наличие расширения в списке выбора файла само по себе не доказывает качество распознавания.
Как превратить разовую расшифровку в рабочий процесс
Для одной записи достаточно пройти шаги вручную. Когда сообщения приходят каждый день, появляется другая задача: не потерять файл, правильно связать его с клиентом, показать сомнительные места и передать подтверждённое дальше.
Понятная последовательность выглядит так:
- Получить и сохранить сообщение.
- Связать его с нужным клиентом или проектом.
- Получить текст.
- Проверить критичные сведения и неизвестное.
- Уточнить условия у человека.
- Передать подтверждённый результат в дальнейшую работу.
Это схема процесса, а не заявление, что вся цепочка уже автоматически работает в нашем аудиопримере. Мы проверили шаг получения текста; остальные действия разобрали отдельно.
Если дальше нужны поручения и сроки, переходи к протоколу встречи в «Штабе». Если не хватает фотографий, файлов и ответов клиента — к сборщику материалов. Если пора согласовать объём и стоимость — к подготовке коммерческого предложения.
В платной Лаборатории следующий шаг — применить подход к своей рабочей задаче. Состав материалов и условия доступа к отдельным разработкам проверяй по актуальному предложению клуба. Внедрение под ключ обсуждается отдельно.
Забери файлы и проверь свой результат
- Исходная учебная запись, WAV, около 41 секунды.
- Текст, который действительно вернул сервис распознавания.
- Карточка проверки шести важных деталей, CSV.
Чтобы проверить себя, сначала прослушай запись и заполни карточку. Затем сравни с таблицей в статье. Для своей работы замени пример одной разрешённой записью и отмечай время на распознавание, прослушивание и исправления отдельно. Так ты увидишь реальные затраты, а не только скорость появления текста.
Частые вопросы
Можно ли расшифровать голосовое сообщение из Telegram?
Если ты можешь сохранить его аудиофайлом, дальше применяется тот же подход: загрузить запись, получить текст и проверить важное. В этом опыте мы загружали подготовленный WAV-файл. Прямой приём голосовых Telegram и их автоматическую передачу в «Штаб» здесь не проверяли.
Расшифровка и протокол — одно и то же?
Нет. Расшифровка передаёт сказанное. Протокол выделяет решения, поручения и вопросы. Сначала проверь слова, затем переходи к смысловой обработке. Иначе ошибка в сумме или сроке попадёт сразу в готовую задачу.
Можно ли сразу доверить ИИ запись клиента?
Можно получить черновик, но сведения, влияющие на деньги и обязательства, нужно сверять. В нашей записи особенно важны исправление числа и уточнение о бюджете. Хорошая пунктуация не подтверждает, что условия поняты правильно.
Какую экономию даёт такой подход?
На коротком синтетическом примере нельзя посчитать экономию живой команды. Для оценки возьми несколько типичных разрешённых записей и сравни полный путь: получение текста, проверка, исправления и подготовка рабочего результата. Поможет разбор оценки результата внедрения ИИ.
Как выбрать режим распознавания для своей записи
После проверки исходника выбери режим по состоянию аудио. Завершённую запись или ограниченный аудиофрагмент передают в файловую транскрипцию. Звук, который ещё поступает с микрофона, из звонка или медиапотока, обрабатывают через Realtime transcription.
Расшифровка и протокол решают разные задачи. Первая передаёт сказанные слова, а второй выделяет решения, поручения и вопросы. Поэтому даже качественно распознанный текст ещё не становится готовой рабочей карточкой.
- Выбери файловую транскрипцию, если запись уже завершена и сохранена отдельным файлом.
- Выбери Realtime transcription, если звук продолжает поступать во время распознавания.
- Выбери gpt-4o-transcribe-diarize, если в готовой записи нужно разметить участки разных говорящих.
- Выбери перевод через /v1/audio/translations с whisper-1, если готовую аудиозапись нужно перевести на английский.
Какая модель подходит для обычной записи
Для расшифровки записанной речи на исходном языке OpenAI рекомендует начинать с gpt-transcribe. Модель возвращает текст расшифровки и определённые языки в JSON.
Если язык не удалось определить надёжно, в поле languages возвращается пустой массив. Это не подтверждает язык записи и не даёт основания самостоятельно подписывать его без дополнительной проверки.
Когда нужны подсказки с терминами
Параметры prompt, keywords и languages можно использовать, чтобы улучшить распознавание профессиональных терминов и многоязычного аудио. Это полезно, когда в записи встречаются названия продуктов, фамилии, сокращения или слова из узкой области.
Keywords работают как подсказки, а не как обязательный текст результата. Наличие термина в списке не гарантирует, что модель вставит его в расшифровку, поэтому важные слова всё равно нужно сверять со звуком.
Для gpt-transcribe поле languages заменяет поле language. Одновременно передавать оба поля нельзя.
Чем диаризация отличается от определения личности
Диаризация разделяет запись по говорящим и показывает, кто говорит на разных участках. Это не обязательно означает установление личности человека. Например, Rev AI поддерживает диаризацию, но не поддерживает идентификацию говорящих.
В Rev AI доступно до 8 говорящих для английской транскрипции и до 6 для неанглийской. Если участников больше, этот предел нужно учитывать до обработки записи.
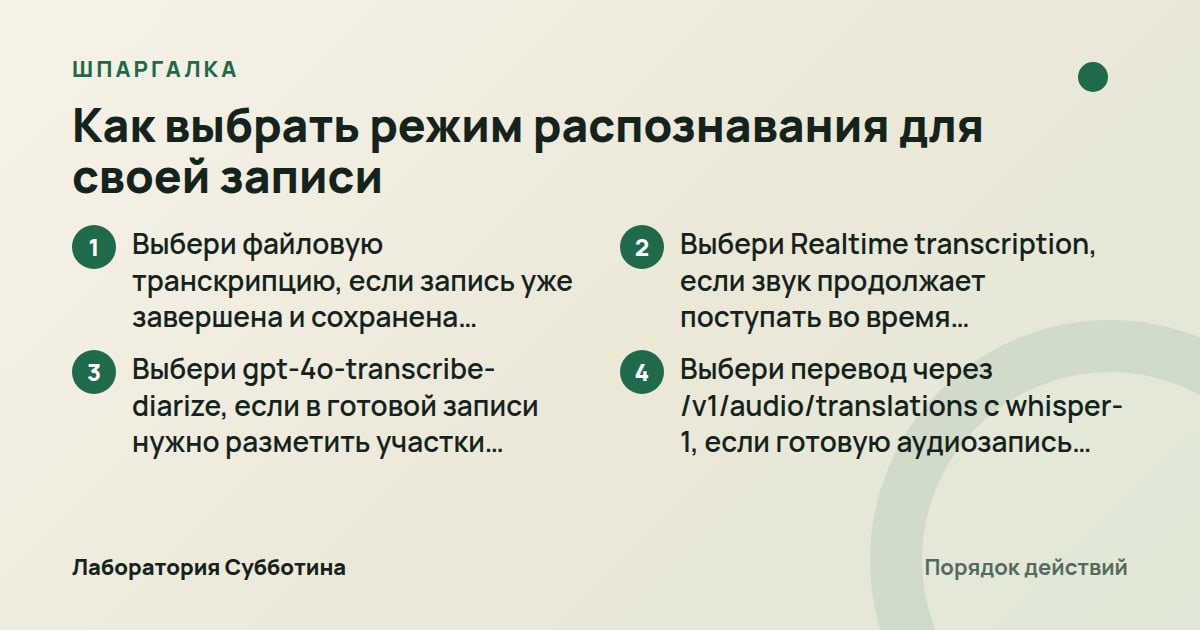
Шпаргалка по разделу «Как выбрать режим распознавания для своей записи».
Как обработать запись, которая не помещается в один запрос
Сначала сравни файл с ограничениями выбранного способа загрузки. У OpenAI загружаемый файл может занимать до 25 МБ, а в проверяемом обработчике «Штаба» также установлен лимит 25 МБ. Если запись больше, её нужно подготовить до запуска распознавания.
- Сохрани исходное аудио отдельно и дай файлу понятное имя.
- Проверь, что выбран нужный файл, звук слышен и запись не оборвалась.
- Возьми нужный фрагмент или раздели большую запись на части, сохранив их порядок.
- Загрузи части последовательно, не меняя порядок исходного разговора.
- Сохрани исходную расшифровку отдельно от рабочей карточки с подтверждёнными условиями.
- Вернись к оригиналу, если в одной из частей появилось спорное число или слово.
Какие форматы принимает OpenAI
Для файловой транскрипции OpenAI поддерживает mp3, mp4, mpeg, mpga, m4a, wav и webm. Перед загрузкой проверь не только расширение, но и размер файла.
Как подготовить длинную запись для диаризации
Для gpt-4o-transcribe-diarize при аудио длиннее 30 секунд нужно установить chunking_strategy в auto или передать конфигурацию VAD. VAD означает определение участков с голосовой активностью.
Чтобы сопоставить сегменты с известными говорящими, можно передать до четырёх коротких эталонных фрагментов вместе с known_speaker_names[] и known_speaker_references[]. Каждый такой фрагмент должен длиться от 2 до 10 секунд и быть записан в формате, который поддерживает основная загрузка.
Маркировка говорящих доступна через /v1/audio/transcriptions, но не поддерживается в сессиях Realtime transcription. Если имена спикеров нужны в итоговом тексте, потоковый режим для этой задачи не подходит.
Какие пределы есть у длинных файлов
Amazon Transcribe принимает обычный аудиофайл длительностью до 28 800 секунд и размером до 2 ГБ. Минимальная длительность файла составляет 500 миллисекунд.
В асинхронном Rev AI максимальная длительность аудио составляет 17 часов. Multipart-загрузка через /jobs ограничена размером 2 ГБ на запрос и пятью параллельными файлами.
Через панель Rev AI или параметр source_config можно загружать файлы размером до 5 ТБ. Это отдельный вариант загрузки, поэтому лимит нельзя автоматически переносить на multipart-запросы к /jobs.
Источник: developers.openai.com.
Какие условия влияют на выбор сервиса
Сравнивать сервисы только по названию модели недостаточно. Для рабочего процесса важны поддерживаемые языки, предел одного файла, допустимая длительность, потоковый режим, количество одновременных заданий и срок хранения результата.
Условия и тарифы ниже приведены по данным сервисов на 5 октября 2026 года. Перед подключением проверь действующие значения на официальной странице выбранного сервиса.
- Проверь, соответствует ли язык записи асинхронному или потоковому режиму.
- Проверь размер и длительность одного файла до загрузки.
- Проверь лимит одновременных потоков или заданий, если записи будут обрабатываться параллельно.
- Проверь срок хранения завершённых заданий и настройку автоудаления.
- Проверь, нужна ли отдельная плата за диаризацию, подсказки с терминами или обработку чувствительных данных.
Что учитывать в Amazon Transcribe
Стандартный лимит Amazon Transcribe составляет 25 параллельных потоковых транскрипций на поддерживаемый регион. Для параллельных заданий транскрипции стандартный предел выше: 250 заданий на поддерживаемый регион.
Записи о заданиях Amazon Transcribe хранятся 90 дней. Этот срок относится к записям о заданиях и не заменяет собственные правила хранения исходного аудио и рабочего результата.
Что учитывать в Rev AI
Rev AI поддерживает более 58 языков в асинхронном Speech-to-Text API и более 9 языков в потоковом API. Число языков зависит от режима, поэтому поддержку нужного языка следует проверять именно для выбранного API.
Потоковый API Rev AI допускает 10 параллельных потоков. Один поток может продолжаться до 3 часов.
Завершённые задания остаются доступными на сервере 30 дней, если для аккаунта не настроен более короткий срок автоматического удаления.
Что учитывать в Google Cloud Speech-to-Text
Локальный файл, отправляемый в одном запросе Google Cloud Speech-to-Text, ограничен размером 10 МБ. Синхронный запрос рассчитан примерно на одну минуту аудио, асинхронный примерно на 480 минут, а потоковый примерно на пять минут.
Сервис допускает 900 запросов распознавания за 60 секунд. Дневной лимит обработки составляет 480 часов аудио. Эти значения важны для пакетной обработки, даже если отдельный файл укладывается в ограничения.
Как оценить платные части до запуска обработки
Распознавание может оплачиваться отдельно или расходовать лимит подключённого сервиса. Сначала определи режим, длительность записи и нужные дополнительные функции, а затем сверяй цену на официальной странице.
У AssemblyAI цена зависит от модели и режима. Universal-3.5 Pro для предварительно записанного аудио стоит $0.21 в час, примерно 18 ₽ по курсу ЦБ на 3 октября 2026 года. Universal-2 стоит $0.15 в час, примерно 13 ₽ по тому же курсу.
- Keyterms Prompting для Universal-3.5 Pro стоит $0.05 в час, примерно 4 ₽ по курсу ЦБ на 3 октября 2026 года; для Universal-2 функция включена.
- Speaker Diarization стоит $0.02 в час, примерно 2 ₽ по курсу ЦБ на 3 октября 2026 года, для Universal-3.5 Pro и Universal-2.
- Medical Mode стоит $0.15 в час, примерно 13 ₽ по курсу ЦБ на 3 октября 2026 года, для Universal-3.5 Pro и Universal-2.
- Universal-3.6 Pro Realtime стоит $0.45 в час, примерно 38 ₽ по курсу ЦБ на 3 октября 2026 года.
- Universal-Streaming и Universal-Streaming Multilingual стоят по $0.15 в час, примерно 13 ₽ по курсу ЦБ на 3 октября 2026 года.
- Sync API стоит $0.45 в час, примерно 38 ₽ по курсу ЦБ на 3 октября 2026 года.
- Dictation API стоит $0.62 в час, примерно 52 ₽ по курсу ЦБ на 3 октября 2026 года.
Как устроены планы Deepgram
Deepgram Pay As You Go включает бесплатный кредит $200, примерно 16 697 ₽ по курсу ЦБ на 3 октября 2026 года, после чего применяется оплата по мере использования. План Growth стоит от $4K в год и работает на предоплаченных годовых кредитах, которые списываются по фактическому использованию.
Для готовых записей Nova-3 Monolingual стоит $0.0043 в минуту по Pay As You Go и $0.0036 в минуту по Growth. Nova-3 Multilingual стоит $0.0052 и $0.0043 в минуту соответственно.
Whisper Large для готовых записей стоит $0.0048 в минуту на обоих планах. Smart Formatting, которое форматирует пунктуацию, регистр, даты и валюту, включено в Pay As You Go и Growth.
Какие дополнения оплачиваются отдельно
В Deepgram редактирование PII для готовых записей стоит $0.0020 в минуту по Pay As You Go и $0.0017 в минуту по Growth. Функция предназначена для автоматического обнаружения и удаления чувствительных персональных данных, включая номера социального страхования, банковских карт и телефонов.
Keyterm Prompting для готовых записей стоит $0.0013 в минуту по Pay As You Go и $0.0012 в минуту по Growth. Его назначение состоит в улучшении распознавания отраслевого жаргона, названий продуктов и сокращений.
Лимиты и параметры сервисов распознавания
| Сервис или режим | Ограничение или цена | Когда учитывать |
|---|---|---|
| OpenAI, файловая транскрипция | Файл до 25 МБ; mp3, mp4, mpeg, mpga, m4a, wav или webm. | Для завершённой записи или ограниченного аудиозапроса. |
| Amazon Transcribe | До 28 800 секунд и 2 ГБ; минимум 500 миллисекунд. | Для обычного аудиофайла в поддерживаемом регионе. |
| Rev AI, асинхронный API | До 17 часов; multipart до 2 ГБ на запрос и пяти параллельных файлов. | Для длинных готовых записей и пакетной загрузки. |
| Rev AI, панель или source_config | Файл до 5 ТБ. | Когда multipart-предел 2 ГБ не подходит. |
| Google Cloud Speech-to-Text | Локальный файл до 10 МБ; синхронно примерно одна минута, асинхронно примерно 480 минут, поток примерно пять минут. | При выборе типа запроса по длительности аудио. |
| AssemblyAI Universal-3.5 Pro | $0.21 в час, примерно 18 ₽ по курсу ЦБ на 3 октября 2026 года. | Для предварительно записанного аудио. |
| AssemblyAI Universal-2 | $0.15 в час, примерно 13 ₽ по курсу ЦБ на 3 октября 2026 года. | Для предварительно записанного аудио. |
| Deepgram Nova-3 Monolingual | $0.0043 в минуту по Pay As You Go и $0.0036 в минуту по Growth. | Для готовых записей. |
| Deepgram Nova-3 Multilingual | $0.0052 в минуту по Pay As You Go и $0.0043 в минуту по Growth. | Для готовых записей с несколькими языками. |
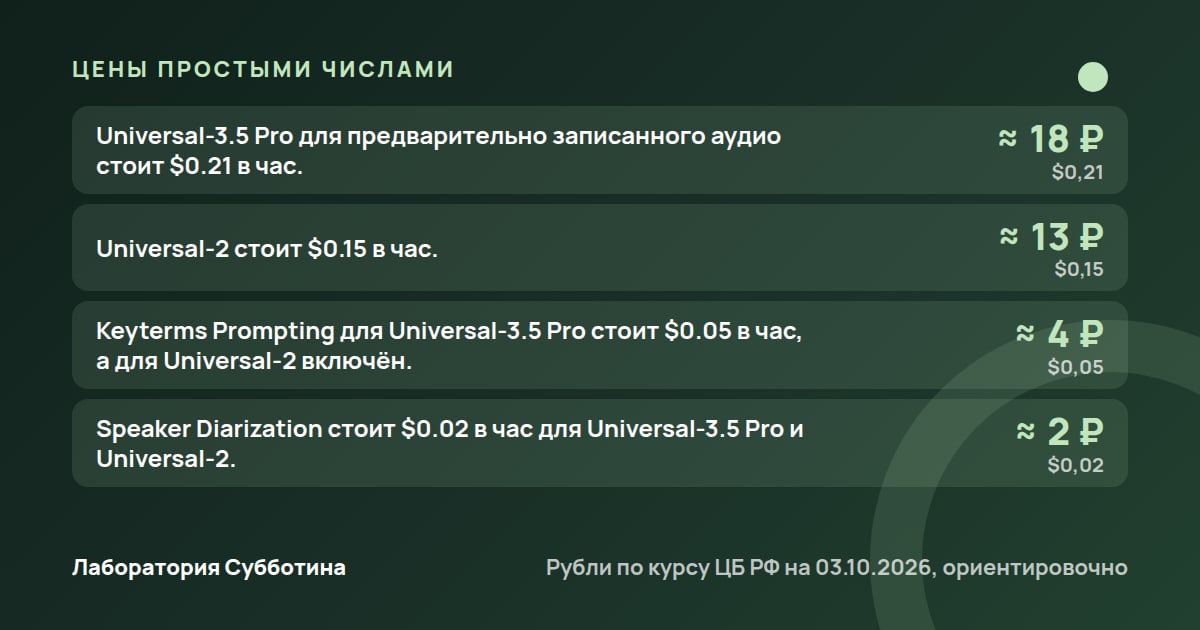
Цены из источников. Рубли по курсу ЦБ РФ на 03.10.2026, ориентировочно.
Что делать, если расшифровка получилась неточной
Не начинай с исправления каждой запятой. Сначала найди ошибки, которые меняют условия работы или влияют на деньги: суммы, даты, фамилии и отрицания. Эти места нужно переслушать по оригиналу.
Не угадывай неразборчивое слово по контексту. Пометь его как «нужно уточнить», а затем задай говорящему короткий вопрос.
- Если имя или число выглядит странно, исправь его вручную после сверки или уточни у говорящего.
- Если две фразы противоречат друг другу, сохрани обе и уточни итоговое условие.
- Если позднее сообщение меняет раннее, сохрани порядок всех сообщений перед разбором.
- Если язык не определён надёжно и languages содержит пустой массив, не назначай язык только по предположению.
- Если keyword не появился в тексте, переслушай участок: подсказка не гарантирует включение термина.
- Если запись содержит чувствительные данные, без необходимости не загружай её в сервис.
Если пропали имена говорящих
Проверь выбранный режим. Маркировка говорящих в OpenAI доступна через /v1/audio/transcriptions, но не в Realtime transcription. Для готовой записи с несколькими участниками применяется gpt-4o-transcribe-diarize.
Если используешь Rev AI, учитывай разницу между разметкой и идентификацией. Сервис может разделить реплики по говорящим, но не устанавливает их личности.
Если сервис отклоняет файл
Сверь размер, длительность и формат с выбранным способом отправки. Например, OpenAI принимает файлы до 25 МБ в форматах mp3, mp4, mpeg, mpga, m4a, wav и webm, а локальный файл в одном запросе Google Cloud Speech-to-Text ограничен 10 МБ.
Если multipart-загрузка Rev AI не проходит при большом файле, проверь предел 2 ГБ на запрос и лимит пяти параллельных файлов. Для панели Rev AI и source_config действует другой предел: до 5 ТБ.
Если условия разговора расходятся
Не выбирай одну версию самостоятельно. Оставь обе фразы в рабочем материале, сохрани последовательность сообщений и уточни у клиента итоговое условие.
Переноси условия в рабочую задачу, предложение или карточку клиента только после подтверждения. До этого исходная расшифровка должна храниться отдельно от рабочей карточки.
Как проверить результат перед переносом условий в работу
Готовый текст нельзя оценивать только по тому, насколько гладко он читается. Проверка должна подтвердить важные слова по аудио, сохранить спорные места и отделить дословную расшифровку от решений и поручений.
- Убедись, что исходное аудио сохранено отдельно и не заменено исправленной версией.
- Проверь, что все части длинной записи расположены в исходном порядке.
- Переслушай участки с суммами, датами, фамилиями и отрицаниями.
- Пометь неразборчивые слова как требующие уточнения.
- Сохрани первоначальную расшифровку отдельно от рабочей карточки.
- Подтверди важные условия и задай оставшиеся вопросы коротким сообщением.
- Перенеси подтверждённые условия в рабочую систему только после ответа клиента.
- Отдельно выдели решения, поручения и вопросы, если нужен протокол, а не только расшифровка.
Когда достаточно файловой транскрипции
Файловый режим подходит, когда запись завершена и представляет собой ограниченный аудиозапрос. Он позволяет сначала получить текст, а затем вернуться к конкретным местам оригинала для проверки.
Если задача состоит в переводе готовой записи на английский, вместо обычной транскрипции используется /v1/audio/translations с whisper-1.
Когда нужен другой способ
Для поступающего звука выбери Realtime transcription. Если при этом требуется маркировка говорящих, учти, что она не поддерживается в сессиях Realtime transcription OpenAI.
Для больших файлов сравни пределы до выбора сервиса: OpenAI допускает до 25 МБ, Amazon Transcribe до 2 ГБ, multipart-загрузка Rev AI до 2 ГБ на запрос, а панель Rev AI или source_config до 5 ТБ.
Для большого потока заданий сравни параллельные ограничения: Amazon Transcribe допускает 25 потоковых транскрипций и 250 заданий на поддерживаемый регион, а потоковый Rev AI допускает 10 параллельных потоков.
Что перепроверить перед подключением
На официальной странице сервиса проверь актуальные цены, состав платных дополнений, поддерживаемые языки и ограничения выбранного API. Значения в этом дополнении зафиксированы на 5 октября 2026 года.
Отдельно проверь правила хранения и удаления результатов. Amazon Transcribe хранит записи о заданиях 90 дней, а Rev AI сохраняет завершённые задания 30 дней, если не настроено более раннее автоудаление.
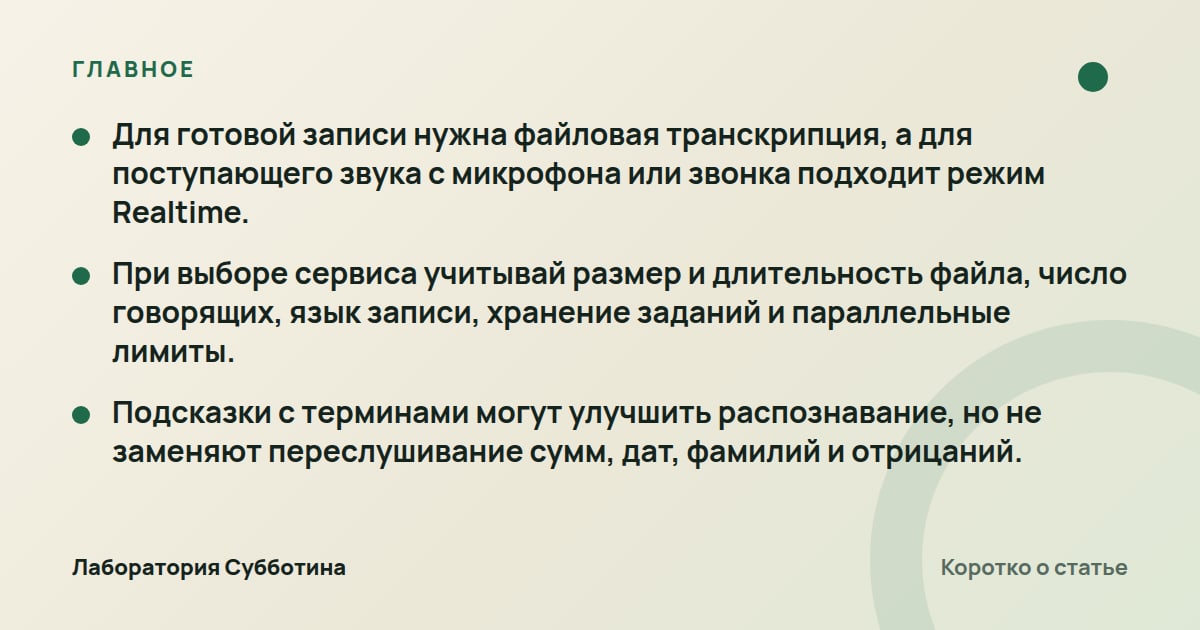
Главное из статьи.
Частые вопросы
Какой режим выбрать для уже записанного созвона?
Используй файловую транскрипцию: она предназначена для завершённых записей и ограниченных аудиозапросов. Для распознавания речи на исходном языке OpenAI рекомендует начинать с gpt-transcribe.
Можно ли получить имена говорящих в режиме Realtime?
Маркировка говорящих OpenAI доступна через /v1/audio/transcriptions и не поддерживается в сессиях Realtime transcription. Для готовой записи, где нужно разделить говорящих, применяется gpt-4o-transcribe-diarize.
Поможет ли список терминов избежать всех ошибок?
Параметры prompt, keywords и languages могут улучшить распознавание терминов и многоязычного аудио, но keywords остаются подсказками и не гарантируют появление нужных слов в результате.
Что делать, если сервис не смог определить язык?
Если gpt-transcribe не делает надёжного предположения, он возвращает пустой массив languages. Не назначай язык только по догадке и проверь запись отдельно.
Какой сервис допускает загрузку очень большого файла?
В Rev AI через панель или параметр source_config можно загружать файлы до 5 ТБ. Для multipart-загрузки через /jobs действует другой предел: 2 ГБ на запрос и пять параллельных файлов.
Сколько хранятся завершённые задания?
Записи о заданиях Amazon Transcribe хранятся 90 дней. В Rev AI завершённые задания доступны 30 дней, если для аккаунта не настроен более короткий срок автоудаления.
Можно ли считать расшифровку готовым протоколом?
Нет. Расшифровка передаёт сказанное, а протокол отдельно выделяет решения, поручения и вопросы. Перед переносом условий в работу важные места нужно проверить и подтвердить.
Источники и проверка
- File transcription | OpenAI API, developers.openai.com. Прочитано 5 октября 2026.
- Amazon Transcribe endpoints and quotas, docs.aws.amazon.com. Прочитано 5 октября 2026.
- AssemblyAI | Pricing | Production-ready AI Models, assemblyai.com. Прочитано 5 октября 2026.
- Deepgram Pricing | Scalable Speech-to-Text, Text-to-Speech & Voice Agent APIs, deepgram.com. Прочитано 5 октября 2026.
- Frequently Asked Questions, docs.rev.ai. Прочитано 5 октября 2026.
- Quotas e limites | Cloud Speech-to-Text | Google Cloud Documentation, docs.cloud.google.com. Прочитано 5 октября 2026.
Что должно получиться
Сохранились не только числа, но и слова «после», «до», «если» и «не», от которых зависит договорённость.
Ответ ИИ не подходит — что исправить?
Выбери одну неверную фразу. Покажи ИИ, где правильные сведения, и напиши: «Исправь только это место по моему исходнику. Если ответа нет, так и скажи». Затем сравни исправление с исходником ещё раз.
Если не хватает самих данных, сначала найди их или задай вопрос ответственному. Новое задание нейросети не заменит отсутствующие условия.
От разговора до выполненного поручения
Чтобы расшифровка не оставалась ещё одним забытым файлом. Нужен порядок: кто проверяет смысл, кто подтверждает срок и где команда увидит поручение.
- Сохранён разговор
- Подготовлен текст
- Выделены договорённости
- Ответственные подтвердили
- Поручения переданы в работу
Собрать такой порядок в своей работе
В платной Лаборатории описываешь процесс из своей головы: что его запускает, кто что делает, какие сервисы нужны и где проверять результат. Затем переходишь к сборке и испытанию выбранного участка.