
Главное за минуту
- Длинное тире само по себе не определяет результат GPTZero: проверять нужно содержательные шаблоны.
- Детекторы могут ошибочно помечать человеческий текст как созданный ИИ, в том числе уверенно.
- Для правки задай формат, ограничения и примеры нужного стиля вместо расплывчатой просьбы «сделай человечнее».
Что действительно помогает отличить текст ИИ
Проверяй повторяющиеся речевые шаблоны и ссылки на неназванные авторитеты, но не принимай результат детектора за доказательство авторства: человеческий текст тоже может получить уверенную ошибочную оценку. Для редактирования используй промпт с конкретными требованиями и примерами нужного стиля.
Раздели проверку происхождения и редактирование
Copyleaks AI Content Detection предназначен для различения человеческого текста и текста ИИ. Это задача классификации: сервис относит материал к определённой категории. Если тебе нужно разобраться с происхождением текста, такая проверка соответствует назначению инструмента, но сама формулировка назначения не сообщает, насколько верен конкретный результат.
У редакторского запроса другая цель: получить нужный формат, тон и структуру. В рекомендациях Claude для этого предлагаются явные ограничения и примеры. Поэтому запрос на правку лучше строить вокруг желаемого результата: как должен выглядеть текст и каким образцам соответствовать.
Ищи объяснимые особенности текста
В GPTZero функция AI Patterns выявляет, извлекает и объясняет повторяющиеся стилистические и риторические шаблоны. Это позволяет обсуждать конкретные фрагменты документа: какую конструкцию выделил инструмент и что именно в ней повторяется. По данным сервиса на 14 октября 2026 года, функция доступна в режиме Advanced Scan.
- Для проверки происхождения рассматривай классификацию текста как отдельный результат анализа.
- Для разбора формулировок обращайся к объяснениям повторяющихся шаблонов.
- Для редактирования формулируй требования к тону, структуре и формату ответа.
Какие признаки проверять, а какие не переоценивать
GPTZero сообщает о десяти шаблонах письма, включённых в описанный выпуск. Это набор категорий внутри инструмента: название функции и количество шаблонов сами по себе не превращают каждую отмеченную конструкцию в доказательство машинного происхождения. Для содержательного разбора важнее объяснение конкретного фрагмента.
Неназванные эксперты вместо источника
Шаблон Phantom Experts означает приписывание утверждения неназванным авторитетам вместо указания источника. Здесь вопрос к тексту конкретный: кто подтверждает сказанное? При редактуре проверяй, указан ли источник утверждения или вместо него оставлена ссылка на неопределённый авторитет.
В промпте можно назвать эту проблему прямо: попросить выделить места, где утверждения приписаны неназванным авторитетам. Такая инструкция связывает редакторскую задачу с определённым шаблоном, а не с общим впечатлением, что текст выглядит искусственно. Формат замечаний тоже задай заранее.
Тире и точка с запятой
По заявлению разработчиков GPTZero, добавление или удаление точки с запятой либо длинного тире не определяет итоговую классификацию. Поэтому замена этих знаков не даёт основания ожидать конкретного вердикта. Если меняешь пунктуацию, связывай правку с требованиями к оформлению текста, а не с обещанием пройти проверку.
Заголовки и серые фрагменты
В описанной версии GPTZero заголовки маскируются: детектор не учитывает их как признак при анализе. Разработчики объясняют это стремлением предотвратить влияние изменений заголовков на результат. Это особенность обработки документа, а не оценка того, насколько удачно написан заголовок.
- Проверяй, назван ли источник у утверждения, отнесённого к Phantom Experts.
- Учитывай, что изменение тире или точки с запятой не определяет классификацию GPTZero.
- Читай серое выделение как обозначение фрагментов, исключённых из анализа детектором.
Условия проверки и интерпретации результатов на 14 октября 2026 года
| Инструмент или функция | Что учитывать |
|---|---|
| Copyleaks: идентификатор проверки | От 3 до 36 символов; уникальный идентификатор задаёт пользователь. |
| Copyleaks: отправляемый текст | От 255 до 100000 символов для описанного метода API. |
| Copyleaks: AI Logic | Объяснения доступны только для шести языков; для остальных возвращается результат без объяснений. |
| Copyleaks: sandbox | Бесплатное тестирование интеграции с API. |
| GPTZero: AI Patterns | Выявление и объяснение повторяющихся шаблонов в режиме Advanced Scan. |
| GPTZero: серое выделение | Фрагменты, исключённые из анализа детектором. |
| Исторический классификатор OpenAI | Недоступен с 20 июля 2023 года из-за низкой точности. |
Что подготовить перед запросом на правку
Рекомендации по промптам ниже относятся к Claude. Руководство предлагает сначала прочитать страницу конкретной модели, а затем переходить к общим приёмам. Это особенно существенно, если ты переносишь готовый запрос между версиями: поддержка отдельных способов управления ответом может отличаться.
Определи формат и объясни задачу
Сначала сформулируй, какой результат нужен: текст, замечания к нему или ответ по заданной структуре. Руководство рекомендует явно указывать формат и ограничения. Если ожидаешь отдельный список замечаний перед редакцией, включи это требование в запрос, чтобы желаемая последовательность была выражена словами.
Затем объясни причину требований. По рекомендациям Claude, контекст и мотивация помогают модели понять цель и дать более подходящий ответ. В запросе на редактуру можно обозначить, для кого предназначен материал и почему выбранный тон или структура важны для этой задачи.
Подбери близкие и разнообразные примеры
Примеры помогают направлять формат, тон и структуру ответа. Для этой задачи они должны быть близки к реальному сценарию использования: выбирай образцы того типа текста, который собираешься редактировать. Тогда ты задаёшь ориентир через материал, а не оставляешь желаемый стиль неопределённым.
Руководство также рекомендует разнообразить примеры и включать пограничные случаи. Цель этой рекомендации: не дать модели усвоить случайные закономерности подборки. Поэтому при подготовке образцов обращай внимание не просто на их количество, а на различия между ситуациями, которые они показывают.
Отдели образцы от инструкций
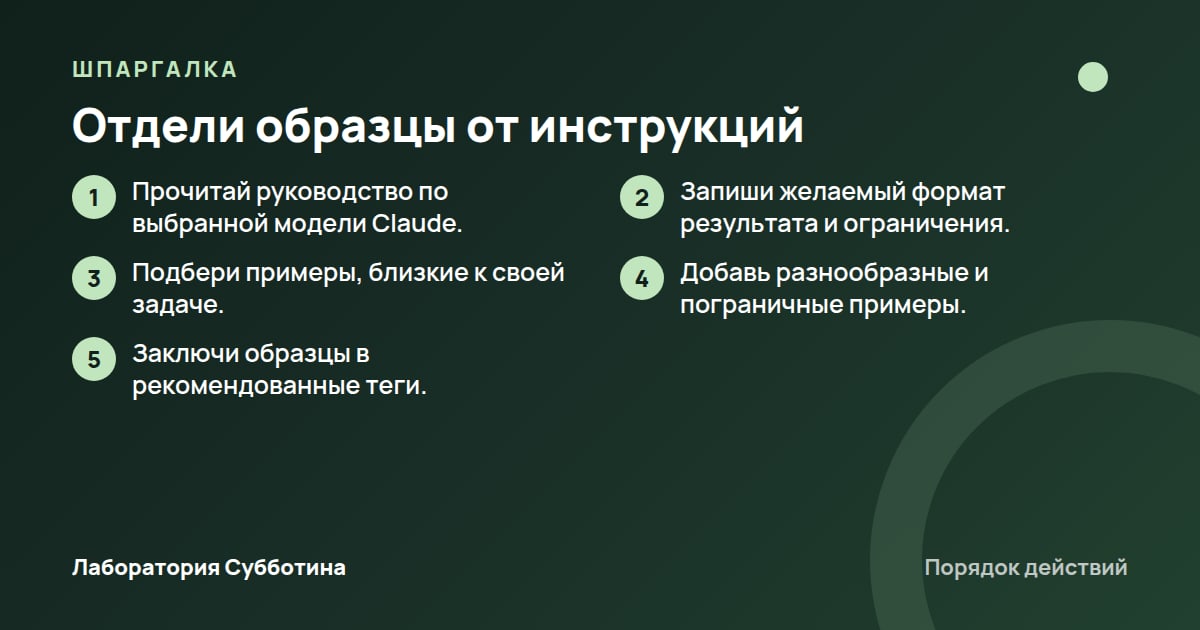
Для отдельного примера рекомендуются теги <example>, для набора примеров используется <examples>. Теги служат разделителями, помогающими отличать образцы от инструкций. В остальных частях запроса придерживайся последовательных и описательных названий, чтобы одинаковые блоки не обозначались по-разному.
- Прочитай руководство по выбранной модели Claude.
- Запиши желаемый формат результата и ограничения.
- Подбери примеры, близкие к своей задаче.
- Добавь разнообразные и пограничные примеры.
- Заключи образцы в рекомендованные теги.
Как составить промпт для содержательной правки
Промпт ниже задаёт редакторскую работу с конкретными особенностями текста. Его основа: явные требования, последовательность действий, объяснение цели и примеры. Результат детектора после такой правки заранее не задан: Copyleaks описывает выявление существенно изменённого текста, а GPTZero отдельно работает с перефразированными материалами.
Собери запрос в понятном порядке
Если работаешь через интерфейс с системным промптом, роль редактора можно задать в нём. Согласно руководству, роль в системном промпте направляет поведение и тон Claude под сценарий использования. При этом конкретные требования к результату всё равно стоит выразить в самой постановке задачи.
- Помести длинный исходный документ ближе к началу промпта, перед запросом, инструкциями и примерами.
- Объясни цель редактирования и причину требований к тексту.
- Задай формат ответа и ограничения правки.
- Перечисли действия в порядке выполнения.
- Добавь подготовленные примеры в теги <examples> и <example>.
Используй заготовку запроса
<document>[Вставь исходный текст]</document> <context>Материал предназначен для [укажи читателя]. Его задача: [укажи задачу]. Требования к тону важны, потому что [объясни причину].</context> <instructions>Выполни редакторскую правку по последовательным шагам. Сначала выдели утверждения, которые приписаны неназванным авторитетам вместо конкретного источника. Затем перечисли замечания к формату, тону и структуре с учётом приложенных образцов. После этого подготовь редакцию в формате [укажи формат]. Соблюдай ограничения: [перечисли ограничения]. Представь замечания отдельным списком перед исправленным текстом.</instructions> <examples><example>[Вставь подходящий образец]</example><example>[Вставь образец другой или пограничной ситуации]</example></examples>
Квадратные скобки здесь обозначают места для твоих требований и материалов. Замени их конкретным содержанием перед отправкой: нужный формат, причина редактирования и образцы должны быть выражены явно. Структура заготовки следует рекомендациям, но её фактическое наполнение определяется твоей задачей.
Дополни запрос для длинного документа
При работе с длинными документами руководство рекомендует сначала попросить Claude процитировать релевантные фрагменты и затем выполнить задачу. Добавь такое действие перед редактурой, если исходник большой. В этом случае перед изменениями ты получишь фрагменты, которые модель сочла относящимися к запросу.
Оформление самого промпта тоже заслуживает внимания: по документации оно может влиять на стиль ответа. Если нужен определённый способ подачи, согласуй с ним оформление инструкций и примеров. Не оставляй структуру запроса случайной, когда структура результата для тебя существенна.
Как читать результаты GPTZero
По информации разработчиков, с 20 сентября 2026 года обновлённая модель доступна всем пользователям и используется в GPTZero по умолчанию. Это сведения, актуальные для проверки материала 14 октября 2026 года. При чтении описаний результатов учитывай, о каком выпуске сервиса идёт речь.
Перефразирование и смешанное авторство
GPTZero 4o нацелен в том числе на сложные случаи: перефразированный текст ИИ и материалы, где машинный текст смешан с человеческим. Поэтому наличие ручных изменений само по себе не выводит документ за пределы описанной задачи детектора. Это заявление о направлении работы модели, а не гарантия конкретной оценки.
Разработчики сообщают, что расширили обучающие данные академическими текстами и публикациями в социальных сетях. Архитектуру также переработали для устойчивости к перефразированию. Эти сведения объясняют, какие материалы и изменения учитывались при разработке, но не подменяют результат проверки твоего документа.
Пояснения к результату
В выпуск добавлены AI Patterns и Masked Detection, чтобы сделать результаты понятнее. При разборе отчёта различай объяснение найденных шаблонов и обозначение исключённых фрагментов. Это разные стороны представления анализа: одна раскрывает особенности текста, другая показывает границы рассмотренного материала.
Что означают опубликованные показатели
На тестовом наборе студенческих эссе разработчики сообщили об одном ложном срабатывании из 10,402. Ложное срабатывание здесь означает ошибочную отметку человеческого текста. Указывай вместе с числом его контекст: это результат описанной проверки на наборе эссе, а не обещание для отдельного документа.
На другом описанном тесте заявлены FPR < 0.03% для человеческих текстов и полнота выявления ИИ > 99% для всех четырёх семейств моделей. FPR обозначает показатель ложных срабатываний, а полнота относится к выявлению ИИ-текстов. Эти числа следует читать вместе с условиями соответствующего теста, не смешивая их с результатом на студенческих эссе.
- Различай сведения о назначении модели и результат проверки документа.
- Соотноси объяснения шаблонов с фрагментами, выделенными AI Patterns.
- Сохраняй указание тестового набора рядом с опубликованными показателями.
Когда пригодится Copyleaks API и что ему передать
Если нужна интеграция проверки в свой процесс, Copyleaks описывает метод API. Для доступа к нему требуется аутентификация с учётной записью и API-ключом. Приведённые ниже условия и ограничения относятся к этому методу по состоянию на 14 октября 2026 года.
Идентификатор и размер текста
Уникальный идентификатор проверки задаёт пользователь. Его длина должна составлять от 3 до 36 символов. Это отдельный параметр запроса: не смешивай ограничение идентификатора с ограничением самого материала, который отправляется на анализ.
Для отправляемого текста указан диапазон от 255 до 100000 символов. Это техническое условие приёма текста описанным методом. Оно не является заявлением о достоверности классификации материалов определённой длины: размер допустимого запроса и результат анализа отвечают на разные вопросы.
Язык и доступность объяснений
Язык содержимого передаётся кодом в формате ISO-639-1. Если поле языка отсутствует, система определяет язык автоматически. Таким образом, в описании метода предусмотрены оба варианта: явное указание языка и его автоматическое определение при отсутствии поля.
Объяснения AI Logic доступны только для шести языков; для остальных возвращается результат без объяснений. Поэтому отсутствие пояснений нужно отличать от отсутствия классификации. Прежде чем рассчитывать на подробный разбор, проверь на официальной странице, входит ли нужный язык в поддерживаемый набор объяснений.
Песочница и последовательность подготовки
Режим песочницы позволяет бесплатно тестировать интеграцию с Copyleaks API. Это условие относится к проверке интеграции в sandbox, а не ко всем вариантам использования сервиса. Точные тарифы для нужного сценария смотри на официальной странице цен.
- Пройди аутентификацию для доступа к методу.
- Задай уникальный идентификатор проверки допустимой длины.
- Проверь длину отправляемого текста.
- Укажи код языка, если передаёшь поле языка.
- Используй песочницу для тестирования интеграции.
Чем отличаются проверки исходного и отредактированного текста
В документации Copyleaks описаны варианты выявления текста с разной степенью изменений. Это полезное различие при выборе сценария проверки: исходная выдача языковой модели, небольшая редактура и существенная переработка рассматриваются отдельно. Не своди описание возможностей к проверке неизменённого ответа.
Какие изменения учитываются
Для небольших изменений документация приводит конкретные примеры: изменение времени и добавление слов. Существенная переработка описана отдельно и может выполняться инструментами или вручную. Эти категории показывают заявленный охват метода, но сами по себе не сообщают точность обнаружения в твоём случае.
- Текст, непосредственно скопированный из языковой модели, например ChatGPT или Gemini, без изменений.
- Текст модели с небольшими изменениями, включая добавленные слова или изменение времени.
- Текст модели, существенно переработанный инструментами или вручную.
Почему части документа получают разные оценки
Copyleaks разделяет классификацию на участки, и разные части материала могут получить разные оценки. Поэтому при чтении результата обращай внимание на границы фрагментов. Оценка отдельной части не должна автоматически превращаться в пересказ результата для документа целиком.
GPTZero отдельно заявляет работу со смешением человеческого и машинного текста. В сравнении возможностей сохраняй это различие формулировок: у Copyleaks описана классификация по участкам, у GPTZero обозначена задача выявления смешанного материала. Это связанные, но не тождественные описания функций.
Почему детектор нельзя превращать в судью
История классификатора OpenAI показывает конкретные ограничения такого подхода. Он стал недоступен с 20 июля 2023 года из-за низкой точности. Рассматривай следующие данные как сведения об этом снятом инструменте, а не как показатели современных Copyleaks или GPTZero.
Ошибки при определении авторства
На сложном наборе английских текстов классификатор OpenAI выявил 26% текстов ИИ и ошибочно пометил 9% человеческих текстов. Здесь описаны разные ошибки: пропуск машинного текста и неверное обвинение человеческого. Эти показатели нельзя объединять в одну оценку без сохранения их смысла и условий тестирования.
OpenAI предупреждала, что человеческий текст иногда получает уверенную ошибочную отметку. На материалах, сильно отличающихся от обучающего набора, уверенность в неверном прогнозе тоже могла быть крайне высокой. Поэтому уверенная формулировка ответа этого классификатора не устраняла возможность ошибки.
Длина и язык меняли надёжность
Надёжность классификатора обычно повышалась с длиной входного текста. Однако тексты короче 1,000 символов считались крайне ненадёжными для проверки, а ошибки встречались и на более длинных материалах. Рост длины здесь описан как тенденция, а не как граница, после которой результат становится достоверным.
Классификатор рекомендовали только для английского текста. На других языках он работал значительно хуже, а для кода был ненадёжен. Это ограничение конкретного инструмента особенно важно сохранять, если приводишь его историю в обсуждении проверки русскоязычных материалов.
Редактирование не решает вопрос происхождения
OpenAI также отмечала, что редактирование ИИ-текста может позволить обойти её классификатор. Это ограничение метода определения происхождения, а не подтверждение качества отредактированного материала. Его не следует превращать в инструкцию по маскировке или переносить как гарантированный результат на другие детекторы.
Рекомендация OpenAI была прямой: не использовать классификатор как основной инструмент принятия решений. Он должен дополнять другие способы определения происхождения текста. Если обсуждаешь спорный материал, сохраняй именно эту вспомогательную роль результата, а не приравнивай его к окончательному заключению.
Кому особенно опасно доверять автоматическому обвинению
В материале Stanford HAI описано исследование ошибок детекторов на эссе TOEFL студентов с неродным английским. Детекторы классифицировали 61.22% этих человеческих работ как созданные ИИ. Это результат конкретного исследования с определённой группой авторов, а не универсальная частота ошибок для текста на любом языке.
Согласие нескольких сервисов тоже могло быть ошибочным
Все семь детекторов единогласно пометили 18 из 91 студенческого эссе TOEFL, то есть 19%, как созданные ИИ. В этом исследовании совпадение результатов разных инструментов не устранило ложные срабатывания. Поэтому сам факт согласия детекторов здесь не подтверждал машинное происхождение работы.
Хотя бы один детектор пометил 89 из 91 эссе TOEFL, или 97%. Это другой показатель: он описывает наличие хотя бы одной отметки, а не единогласное решение. Сохраняй это различие, когда сравниваешь результаты нескольких проверок и обсуждаешь их убедительность.
Особенности языка и образовательные решения
Авторы исследования отмечают, что у неносителей языка обычно ниже показатели лексического богатства, разнообразия, синтаксической и грамматической сложности. Эти особенности относятся к человеческому письму. Поэтому сниженное разнообразие выражений нельзя в контексте такого исследования автоматически истолковывать как подтверждение использования ИИ.
Исследователь рекомендует избегать опоры на детекторы в образовании, особенно при большом числе людей с неродным английским. Это основание не выбирать автоматическую классификацию как решающий способ оценки таких работ. Рекомендация относится именно к образовательному контексту, описанному в материале.
Что делать, если проверка или правка не получилась
Разделяй техническую ошибку запроса, отсутствие объяснений и нежелательное оформление ответа. У этих ситуаций разные описанные причины. Код ошибки API сообщает о запросе или доступе, языковое ограничение влияет на пояснения, а формат ответа Claude связан с инструкциями и возможностями модели.
Copyleaks отклонил запрос
По документации на 14 октября 2026 года коды ниже имеют определённые значения. Они помогают понять категорию проблемы, но не содержат в приведённом описании подробного сценария восстановления. Для дальнейшей диагностики сверяйся с официальной документацией соответствующего метода.
- 400: некорректный запрос; проверь параметры на соответствие требованиям метода.
- 401: авторизация запроса отклонена; проверь выполнение требований аутентификации.
- 429: запрос отклонён из-за слишком большого количества запросов.
Claude не принимает заготовку ответа
Начиная с Claude 4.6 и Claude Mythos Preview заготовки ответа в последнем сообщении ассистента больше не поддерживаются. Речь о частичном сообщении, которое модель должна продолжить. Запросы с такими заготовками к указанным моделям возвращают ошибку 400; условие приведено на 14 октября 2026 года.
Если нужно продолжить прерванный ответ, руководство рекомендует перенести просьбу о продолжении в сообщение пользователя и включить конец предыдущего ответа. Это описанный способ постановки задачи на продолжение вместо неподдерживаемой заготовки последнего сообщения ассистента.
Ответ оформлен не так, как нужно
Последние модели Claude по умолчанию используют LaTeX для математических выражений, уравнений и технических объяснений. LaTeX здесь обозначает способ оформления математического содержимого. Если такой вид ответа не соответствует задаче, явно укажи желаемый формат в запросе.
Если интеграции нужен ответ по заданной схеме, для этого предназначена Structured Outputs. Схема задаёт структуру результата. Это отдельная задача от настройки литературного тона: соответствие структуре и соответствие выбранным примерам письма регулируются разными требованиями.
Что сверить перед использованием результата
Перед работой проверь актуальные условия нужной функции на официальной странице сервиса. Для Claude особенно существенно руководство конкретной модели; для Copyleaks необходимо различать доступ к методу, ограничения текста и доступность объяснений. Приведённые условия зафиксированы на 14 октября 2026 года.
Проверь условия своего сценария
Бесплатное тестирование Copyleaks относится к песочнице для интеграции. Доступность обновлённой модели GPTZero всем пользователям тоже не сообщает цену нужного тебе сценария работы. За точными тарифами обращайся к официальной странице цен соответствующего сервиса.
- Сверь рекомендации для выбранной модели Claude.
- Проверь ограничения длины текста для метода Copyleaks.
- Уточни поддержку AI Logic для нужного языка.
- Сверь доступность AI Patterns в Advanced Scan.
Оцени правку по исходному заданию
Сопоставь редакцию с форматом, ограничениями и примерами, которые ты передал в промпте. Именно они задают проверяемые требования к результату: нужный тон, структуру и способ оформления. Отдельно рассмотри отмеченные ссылки на неназванные авторитеты, если они были предметом правки.
Если после редактирования повторно используешь детектор, сохраняй различие между качеством редакции и предположением о происхождении текста. В рекомендациях OpenAI автоматическая классификация имела вспомогательную роль. Работа с конкретными формулировками позволяет обсуждать правку содержательно, не превращая оценку происхождения в единственный критерий.
Частые вопросы
Можно ли определить нейросеть по длинному тире?
По заявлению разработчиков GPTZero, добавление или удаление длинного тире либо точки с запятой не определяет итоговую классификацию. Поэтому такой знак не даёт основания для уверенного вывода об авторстве.
Какой признак стоит проверить вручную?
Проверь утверждения со ссылками на неназванных авторитетов. GPTZero называет такой шаблон Phantom Experts: утверждение приписывается авторитетам, но источник не указан. Это конкретный предмет редакторской проверки.
Промпт для правки гарантирует человеческую оценку детектора?
Такой результат не следует из описанных возможностей: Copyleaks предусматривает выявление существенно изменённого текста ИИ, а GPTZero нацелен на перефразированные материалы. Промпт задаёт требования к редакции через формат, ограничения и примеры.
Может ли человеческий текст получить уверенную отметку ИИ?
Да. OpenAI прямо описывала такие ошибки у своего классификатора. В исследовании, представленном Stanford HAI, ложные отметки также получали эссе студентов с неродным английским. Это основания учитывать контекст проверки, а не оценивать уверенность ответа отдельно от ошибок метода.
Почему Copyleaks вернул результат без объяснения?
Одна из описанных причин связана с языком: AI Logic предоставляет объяснения только для шести языков. Для остальных метод возвращает классификацию без объяснений. Проверь поддержку нужного языка на официальной странице.
Можно ли бесплатно проверить интеграцию Copyleaks?
По условиям на 14 октября 2026 года для бесплатного тестирования интеграции предусмотрен режим sandbox. Это условие песочницы; актуальные тарифы для другого сценария смотри на официальной странице цен сервиса.
Что делать, если Claude прервал ответ?
Перенеси просьбу о продолжении в сообщение пользователя и включи конец прерванного ответа. Такой способ рекомендуется в руководстве; заготовки последнего сообщения ассистента не поддерживаются начиная с Claude 4.6 и Claude Mythos Preview.
Подходит ли детектор для решения, списал ли студент?
Исследователь в материале Stanford HAI рекомендует избегать опоры на детекторы в образовании, особенно при большом числе людей с неродным английским. Описанные ошибки на эссе TOEFL показывают, почему автоматическую отметку опасно превращать в решающий вывод.
Источники и проверка
- Prompting best practices, platform.claude.com (первоисточник). Прочитано 14 октября 2026.
- AI Text Detector - Copyleaks API Docs, docs.copyleaks.com (первоисточник). Прочитано 14 октября 2026.
- Introducing GPTZero 4o, gptzero.me (первоисточник). Прочитано 14 октября 2026.
- New AI classifier for indicating AI-written text, openai.com (первоисточник). Прочитано 14 октября 2026.
- AI-Detectors Biased Against Non-Native English Writers | Stanford HAI, hai.stanford.edu (первоисточник). Прочитано 14 октября 2026.
Подготовлено с помощью ИИ по первоисточникам и проверено автоматически: факты, числа и цитаты сверены с источниками. Человек статью перед выходом не читал. Если нашёл ошибку, напиши через контакты.