
Главное за минуту
- Для начала рассмотри qwen3:4b размером 2.5GB или qwen3:8b размером 5.2GB, оставляя память под контекст.
- Размер скачиваемой модели не заменяет проверку памяти на рабочих запросах: длина контекста тоже влияет на расход.
- У Gemma 3 4B @ INT4 в таблице указано 2.8 GB при контексте 4K и 14 GB при 128K.
Что рассмотреть для видеокарты с 8 ГБ
Для ПК с 8 ГБ видеопамяти начни подбор с qwen3:4b размером 2.5GB или qwen3:8b размером 5.2GB. Это кандидаты для проверки: скачиваемый файл должен помещаться в видеопамять с запасом под контекст, поэтому размер файла сам по себе не гарантирует работу с нужной длиной запроса.
Что нужно для локального запуска
Локальная языковая модель состоит из весов, среды выполнения и интерфейса. Веса нужно получить, среда загружает и выполняет модель, а интерфейс позволяет с ней взаимодействовать. При выборе способа запуска проверь, что у тебя подготовлены эти части, а не скачан один файл модели.
- Веса: файлы выбранной модели.
- Среда выполнения: программа, которая загружает и выполняет веса.
- Интерфейс: способ взаимодействия с запущенной моделью.
Для каких задач смотреть на Qwen3
Qwen3 поддерживает более 100 языков и диалектов, выполнение инструкций на разных языках и перевод. Если тебе нужна работа с многоязычными запросами, эти возможности дают основание включить семейство в список для собственной проверки.
В каталоге Ollama у рассматриваемых вариантов Qwen3 указан текстовый вход. Если выбираешь модель для другого типа входных данных, проверь описание конкретного варианта на официальной странице, прежде чем скачивать его.
Почему название модели не отвечает на вопрос о памяти
Выбирай конкретный вариант и его скачиваемый размер. В практической инструкции рекомендовано оставлять видеопамять под окно контекста, а затем наблюдать за расходом на реальных запросах. Подбор заканчивается проверкой твоей нагрузки, а не сравнением названия модели с объёмом видеокарты.
Какие варианты Qwen3 сравнить перед скачиванием
В каталоге Ollama есть варианты Qwen3 с разными размерами файлов и окнами контекста. Ниже приведены параметры на дату проверки, 22 октября 2026 года; перед загрузкой сверяй выбранную запись в каталоге.
С чего начать подбор небольшой модели
У qwen3:0.6b указан размер 523MB, у qwen3:1.7b — 1.4GB. У обеих записей окно контекста 40K и текстовый вход. Эти варианты можно включить в подбор, если хочешь начать с небольшого скачиваемого файла, сохраняя принцип запаса памяти под контекст.
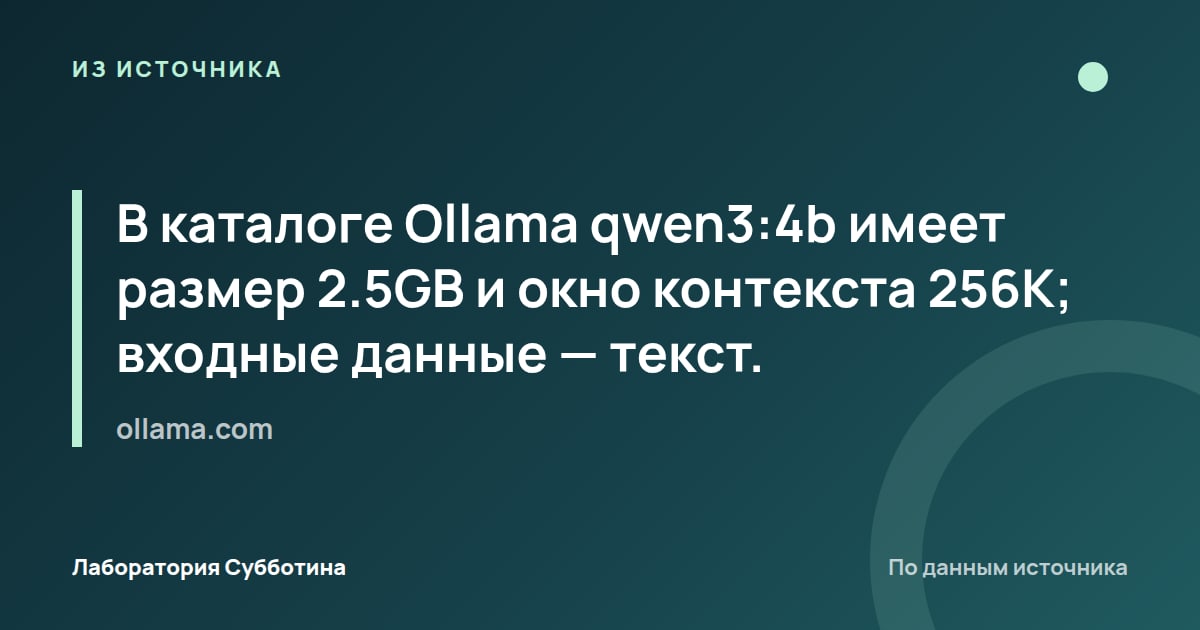
У qwen3:4b размер 2.5GB и окно контекста 256K. Не воспринимай указанное окно как обещание работы с такой длиной на выбранной видеокарте: память нужно оставить и под сам контекст.
Что означает latest в этом каталоге
Запись qwen3:8b помечена latest. Для неё указаны 5.2GB и окно контекста 40K; такие же параметры приведены у qwen3:latest. Если хочешь явно зафиксировать выбранный размер в команде, используй суффикс модели, как в примерах авторов.
Какие файлы выходят за рамки этого подбора
Для qwen3:14b каталог указывает 9.3GB, для qwen3:30b — 19GB. Это не соответствует правилу выбора файла, который помещается в видеопамять с запасом, для рассматриваемой карты. Если нужен такой вариант, отдельно рассматривай распределение модели между процессором и видеокартой.
- qwen3:32b: файл 20GB, окно контекста 40K.
- qwen3:235b: файл 142GB, окно контекста 256K.
- Гибридный режим llama.cpp позволяет распределять модель между CPU и GPU, когда видеопамяти недостаточно.
Размеры файлов Qwen3 в Ollama на дату проверки
| Модель | Скачиваемый размер | Окно контекста |
|---|---|---|
| qwen3:0.6b | 523MB | 40K |
| qwen3:1.7b | 1.4GB | 40K |
| qwen3:4b | 2.5GB | 256K |
| qwen3:8b, помечена latest | 5.2GB | 40K |
| qwen3:14b | 9.3GB | 40K |
| qwen3:30b | 19GB | 256K |
| qwen3:32b | 20GB | 40K |
| qwen3:235b | 142GB | 256K |
Что проверить в компьютере до установки LM Studio
Объём видеопамяти не заменяет проверку требований программы к системе. LM Studio указывает поддерживаемые платформы, требования к процессору и рекомендации по оперативной памяти отдельно для Windows, macOS и Linux.
Windows: процессор и оперативная память
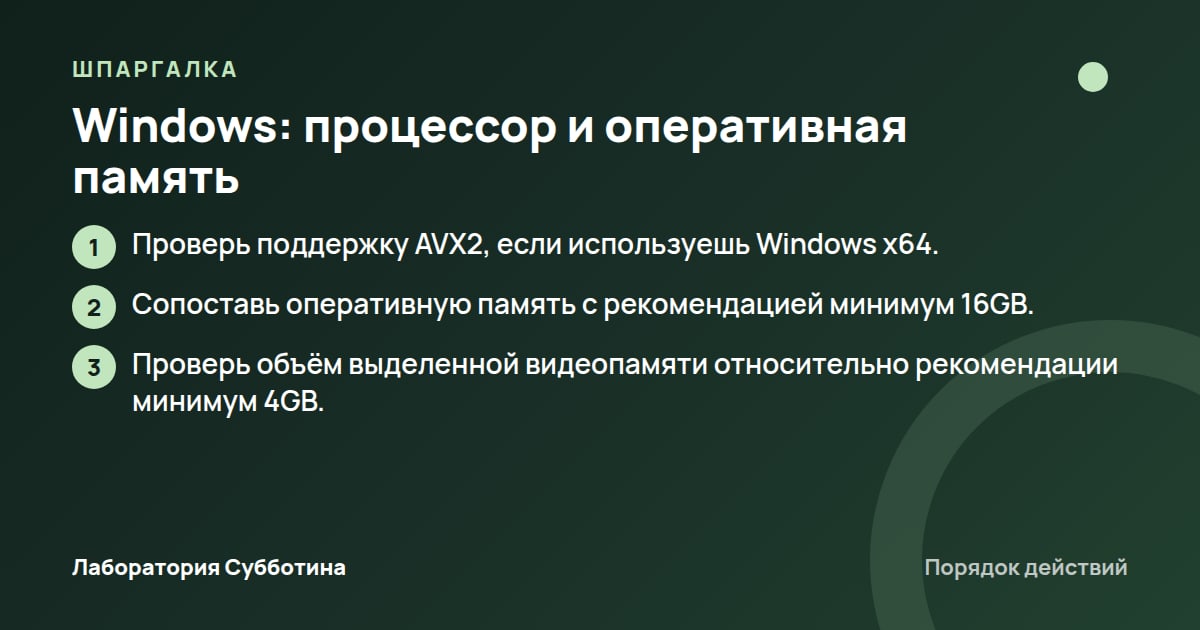
LM Studio поддерживает Windows на системах x64 и ARM на Snapdragon X Elite. Для x64 требуется AVX2, набор инструкций процессора. Проверь это условие до подбора модели: наличие подходящей видеокарты не отменяет требования к процессору.
Для Windows рекомендовано минимум 16GB оперативной памяти и минимум 4GB выделенной видеопамяти. Это рекомендации программы, а не подтверждение, что выбранная модель поместится с нужным контекстом. Для модели остаётся отдельная проверка запаса памяти.
- Проверь поддержку AVX2, если используешь Windows x64.
- Сопоставь оперативную память с рекомендацией минимум 16GB.
- Проверь объём выделенной видеопамяти относительно рекомендации минимум 4GB.
Mac: не путай память компьютера с видеопамятью ПК
На Mac LM Studio поддерживает Apple Silicon M1/M2/M3/M4 и требует macOS 14.0 или новее. Рекомендовано 16GB оперативной памяти или больше. Условия для Mac нужно читать отдельно от рекомендаций для Windows.
LM Studio может работать на Mac с 8GB памяти, но разработчики советуют небольшие модели и умеренный контекст. Mac на процессорах Intel сейчас не поддерживаются; если у тебя такой компьютер, этот вариант программы не подходит по заявленным требованиям.
Linux: поддержка системы и степень проверки
На Linux поддерживаются x64 и ARM64 (aarch64), требуется Ubuntu 20.04 или новее. При этом версии Ubuntu новее 22 недостаточно хорошо протестированы. Учитывай обе оговорки: соответствие требованию по версии и степень её проверки разработчиками.
Как запустить выбранную Qwen3 через Ollama
Авторы Qwen3 описывают запуск через Ollama: сначала служба, затем команда загрузки и запуска модели. В инструкции рекомендована Ollama v0.9.0 или новее; перед установкой проверь актуальные условия на официальной странице программы.
Запусти службу и модель
После установки Ollama можно перейти к командам ниже. В примере указан конкретный вариант Qwen3, поэтому название команды одновременно фиксирует, какую модель ты готовишь к работе. Для выбора размера авторы используют суффикс после имени qwen3.
- Запусти службу командой ollama serve.
- Выполни ollama run qwen3:8b для подготовки и запуска этой модели.
- Наблюдай за памятью на своих реальных запросах.
Не смешивай команды для разных моделей
В другой практической инструкции показана последовательность для llama3.1:8b: команда ollama pull llama3.1:8b скачивает квантованные веса, а ollama run llama3.1:8b начинает интерактивную сессию. Это пример для указанной модели, а не отдельное подтверждение требований Qwen3 к памяти.
Для Qwen3 используй её имя в команде ollama run. Авторы приводят суффиксы:8b и:30b-a3b как примеры выбора размера; наличие примера команды не означает, что соответствующий вариант подходит твоей видеокарте. Размер нужно сопоставить с доступной памятью.
Что нужно при подключении через программный интерфейс
Перед использованием API Ollama авторы предлагают выполнить ollama run qwen3:8b, чтобы подготовить модель. Во время работы через API служба ollama serve должна оставаться запущенной. Эти условия относятся к подготовке и доступности модели для обращения из программы.
Если пишешь собственное подключение, проверь формат ответа и параметры потоковой передачи в официальной документации Ollama.
Как выбрать другой способ запуска
Qwen3 поддерживается несколькими средами. Выбирай способ по своему оборудованию и формату работы: для LMStudio заявлена поддержка файлов GGUF, для Apple Silicon есть mlx-lm, для процессоров и графических процессоров Intel — OpenVINO.
LMStudio и работа без интернета
Авторы Qwen3 сообщают, что модель поддерживается LMStudio и можно напрямую использовать их GGUF-файлы. При таком выборе сначала сопоставь требования программы со своей системой, затем выбирай конкретный файл модели с запасом по видеопамяти.
LM Studio может работать полностью без интернета, если заранее получить файлы моделей. Поэтому для автономной работы подготовь файлы до отключения от сети. Возможность работы без интернета сформулирована именно с этим условием.
Варианты для Apple Silicon и Intel
На Apple Silicon Qwen3 поддерживается библиотекой mlx-lm>=0.24.0. Это отдельный вариант запуска для указанной платформы; требование к версии относится к библиотеке mlx-lm, а не к LM Studio или Ollama.
OpenVINO поддерживает Qwen3 на процессорах и графических процессорах Intel. Если рассматриваешь этот путь, проверяй инструкции OpenVINO для своего оборудования, не перенося на него команды запуска из раздела про Ollama.
Версии библиотек для самостоятельной настройки
На дату проверки для запуска Qwen3 через Transformers требуется transformers>=4.51.0, при этом авторы рекомендуют последнюю версию библиотеки. Для полной поддержки через llama.cpp рекомендована llama.cpp>=b5401.
- Transformers: обязательное условие transformers>=4.51.0 и рекомендация последней версии.
- SGLang: требуется sglang>=0.4.6.post1.
- vLLM: рекомендована vllm>=0.9.0.
Почему контекст меняет расход видеопамяти
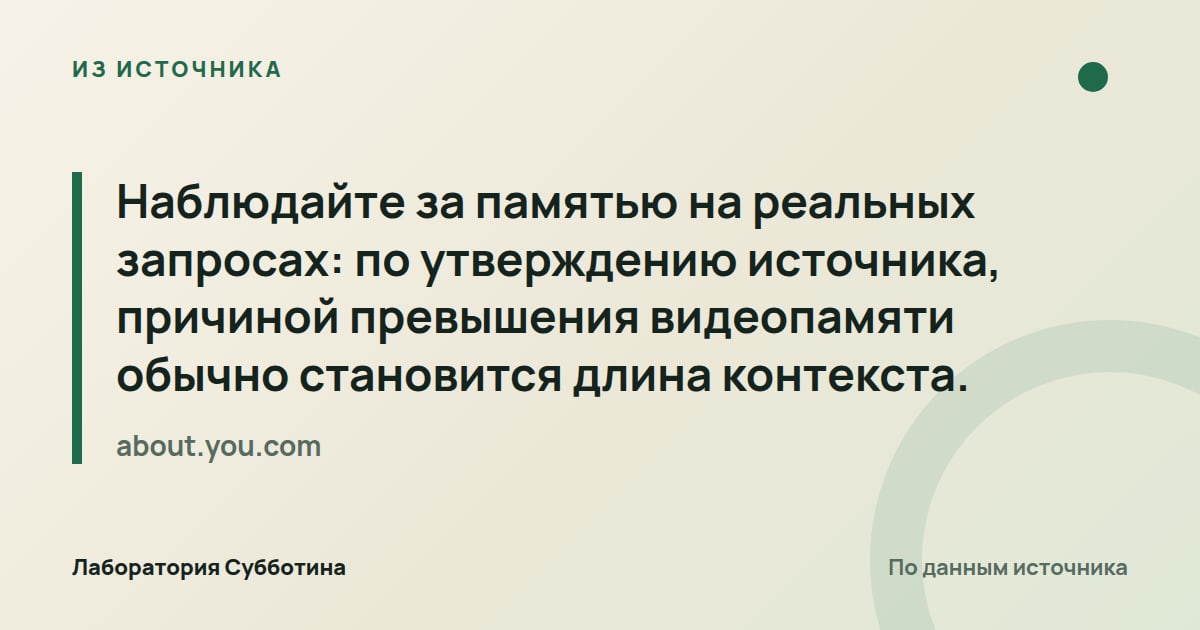
Подбирай модель вместе с длиной контекста, с которой собираешься работать. Практическая инструкция советует следить за памятью на реальных запросах: по утверждению автора, именно длина контекста обычно становится причиной превышения видеопамяти.
Из чего складывается расчёт
В таблице требований Gemma 3 расчёт состоит из размера модели M и размера кэша QKV N. То есть итоговая память включает не один размер модели. При сравнении вариантов смотри на итог для нужного контекста, а не на отдельную часть расчёта.
Страница с этими расчётами обновлена 8 июля 2025 года. Используй её как опубликованный ориентир для перечисленных вариантов Gemma 3, а актуальные требования и поведение на своём компьютере проверяй отдельно.
Как различаются варианты Gemma 3 4B
Для Gemma 3 4B @ FP16 приведены 11 GB при контексте 4K, 12.4 GB при 8K, 20.8 GB при 32K и 54.4 GB при 128K. Уже эти данные показывают, почему обозначения 4B недостаточно для выбора модели под рассматриваемую видеокарту.
Для Gemma 3 4B @ INT4 в тех же столбцах указаны 2.8 GB, 3.2 GB, 5.3 GB и 14 GB. Сравнивай конкретную запись целиком: название модели, обозначение варианта и окно контекста. Значение для короткого окна нельзя переносить на длинное.
Что происходит у более крупных Gemma 3
Для Gemma 3 12B @ INT4 указаны 8 GB, 8.8 GB, 13.6 GB и 32.8 GB. Даже совпадение табличного значения с объёмом видеопамяти не выполняет рекомендацию оставить запас. Не считай такой вариант подтверждённым выбором по одному числу.
- Gemma 3 12B @ FP16: итоги 31.9 GB, 35 GB, 53.6 GB и 128 GB.
- Gemma 3 27B @ FP16: итоги 70.3 GB, 75.8 GB, 108.8 GB и 241 GB.
- Gemma 3 27B @ INT4: итоги 17.6 GB, 19 GB, 27.4 GB и 61 GB.
Что проверить, если модель отвечает не на весь запрос
Отсутствие сообщения об ошибке ещё не подтверждает, что модель получила запрос целиком. В практической инструкции описано обрезание при превышении рабочего контекста: обычно удаляется середина запроса, после чего модель отвечает на изменённый вопрос.
Проверь, сохранилась ли часть запроса
Для обнаружения обрезания источник предлагает запрос с уникальным токеном ближе к началу и просьбой повторить его. Такой тест проверяет сохранение выбранного элемента запроса. Не подменяй им наблюдение за памятью при своей рабочей нагрузке.
- Помести уникальный токен ближе к началу запроса.
- Попроси модель повторить этот токен.
- Проверь, смогла ли модель его повторить.
Обрати внимание на настройки Ollama
Авторы Qwen3 предупреждают о настройках Ollama по умолчанию num_ctx 2048 и num_predict -1. В их описании это контекст 2048 токенов и неограниченная генерация; такое сочетание может вызывать проблемы у Qwen3.
Не путай предупреждение о настройках среды с окном, указанным в каталоге модели. У qwen3:8b в каталоге стоит 40K, но предупреждение авторов касается конкретных параметров Ollama. Перед длинным запросом проверь действующие настройки по официальной инструкции.
Если видеопамяти не хватает
Наблюдай за памятью во время реальных запросов и сопоставляй расход с длиной контекста. Если модель не помещается в видеопамять, у llama.cpp предусмотрен гибридный режим распределения между CPU и GPU. Это отдельный способ размещения модели, который нужно выбирать осознанно.
Как не перепутать выпуски и режимы Qwen3
Серия Qwen3 выпущена 29 апреля 2025 года. В Qwen3-2507 представлены варианты Qwen3-Instruct-2507 и Qwen3-Thinking-2507 в размерах 235B-A22B, 30B-A3B и 4B. При выборе учитывай полное имя выпуска, поскольку режимы у этих вариантов различаются.
Варианты с фиксированным режимом
Qwen3-Instruct-2507 поддерживает только режим без рассуждений и не создаёт блоки <think></think>. Если нужен именно такой формат поведения, проверяй наличие Instruct-2507 в названии выбранного варианта, а не ориентируйся на одно слово Qwen3.
Qwen3-Thinking-2507 поддерживает только режим рассуждений. Не переноси на него ожидание, что режим можно отключить так же, как у предыдущих моделей семейства: для этого выпуска авторы прямо указывают ограничение режима.
Управление предыдущими моделями
Для предыдущих Qwen3 передача enable_thinking=False в tokenizer.apply_chat_template строго запрещает генерацию рассуждений. Это настройка при работе с шаблоном сообщений; её область применения в описании относится к предыдущим моделям.
Авторы также описывают инструкции /think и /no_think в системном или пользовательском сообщении. В многошаговом диалоге действует последняя инструкция. Читай это вместе с ограничениями выбранного выпуска, а не как универсальный переключатель для вариантов с фиксированным режимом.
- Instruct-2507: режим без рассуждений.
- Thinking-2507: режим рассуждений.
- Предыдущие Qwen3: отключение рассуждений через enable_thinking=False.
Где получить веса и что делать со скачиванием
Контрольные точки Qwen3 можно искать в организациях авторов на Hugging Face и ModelScope по именам, начинающимся с Qwen3-. Если получаешь файлы самостоятельно, сверяй полное название найденного варианта с тем, который собираешься запускать.
Какие типы моделей опубликованы
Авторы открыли веса плотных моделей и моделей Mixture-of-Expert (MoE). Эти обозначения встречаются при выборе внутри семейства, но сами по себе не заменяют проверку скачиваемого размера и запаса видеопамяти для нужного контекста.
Если загрузка контрольной точки не получается
Авторы настоятельно рекомендуют ModelScope пользователям, особенно находящимся в материковом Китае. Это рекомендация указанной площадки; не превращай её в вывод о доступности других площадок или условиях для других регионов.
Команда modelscope download может помочь при проблемах со скачиванием контрольных точек. Если столкнулся именно с загрузкой файлов, проверь её использование в официальной инструкции ModelScope, прежде чем менять выбранную модель или среду выполнения.
- Ищи контрольные точки с именами, начинающимися с Qwen3-, на Hugging Face или ModelScope.
- Рассмотри рекомендованный авторами ModelScope, особенно если находишься в материковом Китае.
- Проверь применение modelscope download при затруднениях со скачиванием.
Когда изменить выбор и что сверить перед работой
Возвращайся к подбору, если выбранный файл не оставляет запас под контекст или реальный запрос приводит к превышению видеопамяти. Основание для решения здесь конкретное: размер модели, рабочая длина запроса и наблюдаемый расход памяти.
Когда выбранный вариант не подходит
Для Mac на Intel LM Studio сейчас не подходит по заявленной поддержке платформ. Для Mac с 8GB памяти разработчики советуют небольшие модели и умеренный контекст. Эти ограничения относятся к соответствующим системам, их не следует переносить на другие компьютеры.
Если нужен длинный контекст Gemma 3 4B @ INT4, учитывай табличные 14 GB при 128K. Значение 2.8 GB при 4K не подтверждает размещение той же модели с длинным окном в рассматриваемой видеопамяти.
Что открыть на официальных страницах
Перед скачиванием сверяй запись конкретной модели, требования программы и рекомендации по версиям библиотек. Числа в этом гайде относятся к проверке на 22 октября 2026 года; для дальнейшей настройки используй актуальные страницы выбранных инструментов.
- Сверь размер файла и окно контекста выбранной Qwen3 в каталоге Ollama.
- Сверь требования LM Studio для своей системы.
- Проверь настройки контекста Ollama с учётом предупреждения авторов Qwen3.
- Оцени расход памяти на запросах, с которыми планируешь работать.
Частые вопросы
Какую Qwen3 первой рассмотреть для моей видеокарты?
Начни подбор с qwen3:4b размером 2.5GB или qwen3:8b размером 5.2GB. Оставляй видеопамять под контекст и проверяй расход на реальных запросах: эти размеры файлов дают ориентир для выбора, но не подтверждают работу с нужной тебе нагрузкой.
Почему скачанная модель небольшая, а памяти не хватает?
Память требуется и для контекста. В расчётах Gemma 3 итог складывается из размера модели и кэша QKV; практическая инструкция также предупреждает, что длина контекста обычно становится причиной превышения видеопамяти. Наблюдай за расходом во время своей работы.
Что означает latest у Qwen3 в Ollama?
На дату проверки qwen3:8b помечена latest. Для qwen3:latest и qwen3:8b указаны размер 5.2GB и окно контекста 40K. Чтобы явно указать выбранный размер при запуске, используй суффикс в имени модели.
Можно ли работать в LM Studio без интернета?
Да, LM Studio может работать полностью без интернета, если заранее получить файлы моделей. Подготовь их до автономной работы: это условие прямо указано в требованиях программы.
Что делать, если модель пропускает часть длинного запроса?
Проверь возможное обрезание контекста. Источник предлагает поместить уникальный токен ближе к началу запроса и попросить модель повторить его. При превышении рабочего контекста запрос может обрезаться без сообщения об ошибке, обычно с удалением середины.
Можно ли распределить модель между процессором и видеокартой?
Да, гибридный режим llama.cpp позволяет распределять модель между CPU и GPU, когда она не помещается в видеопамять. Рассматривай это как отдельный способ запуска; для полной поддержки Qwen3 авторы рекомендуют llama.cpp>=b5401.
Как отключить рассуждения у Qwen3?
Это зависит от выпуска. У предыдущих Qwen3 параметр enable_thinking=False в tokenizer.apply_chat_template строго запрещает генерацию рассуждений. Qwen3-Instruct-2507 поддерживает только режим без рассуждений, а Qwen3-Thinking-2507 — только режим рассуждений.
Подходит ли Gemma 3 4B без уточнения варианта?
Смотри на полное обозначение и контекст. Для Gemma 3 4B @ FP16 при 4K указано 11 GB, а для 4B @ INT4 в том же столбце — 2.8 GB. Для INT4 при 128K указано уже 14 GB, поэтому одно название 4B не отвечает на вопрос о памяти.
Источники и проверка
- GitHub - QwenLM/Qwen3: Qwen3 is the large language model series developed by Qwen team, Alibaba Cloud., github.com (первоисточник). Прочитано 22 октября 2026.
- qwen3, ollama.com (первоисточник). Прочитано 22 октября 2026.
- System Requirements, lmstudio.ai (первоисточник). Прочитано 22 октября 2026.
- How to Run an LLM Locally: A Practical Walkthrough for Developers, about.you.com. Прочитано 22 октября 2026.
- Gemma 3 Memory Requirements | RC Learning Portal, learning.rc.virginia.edu. Прочитано 22 октября 2026.
Подготовлено с помощью ИИ по первоисточникам и проверено автоматически: факты, числа и цитаты сверены с источниками. Человек статью перед выходом не читал. Если нашёл ошибку, напиши через контакты.